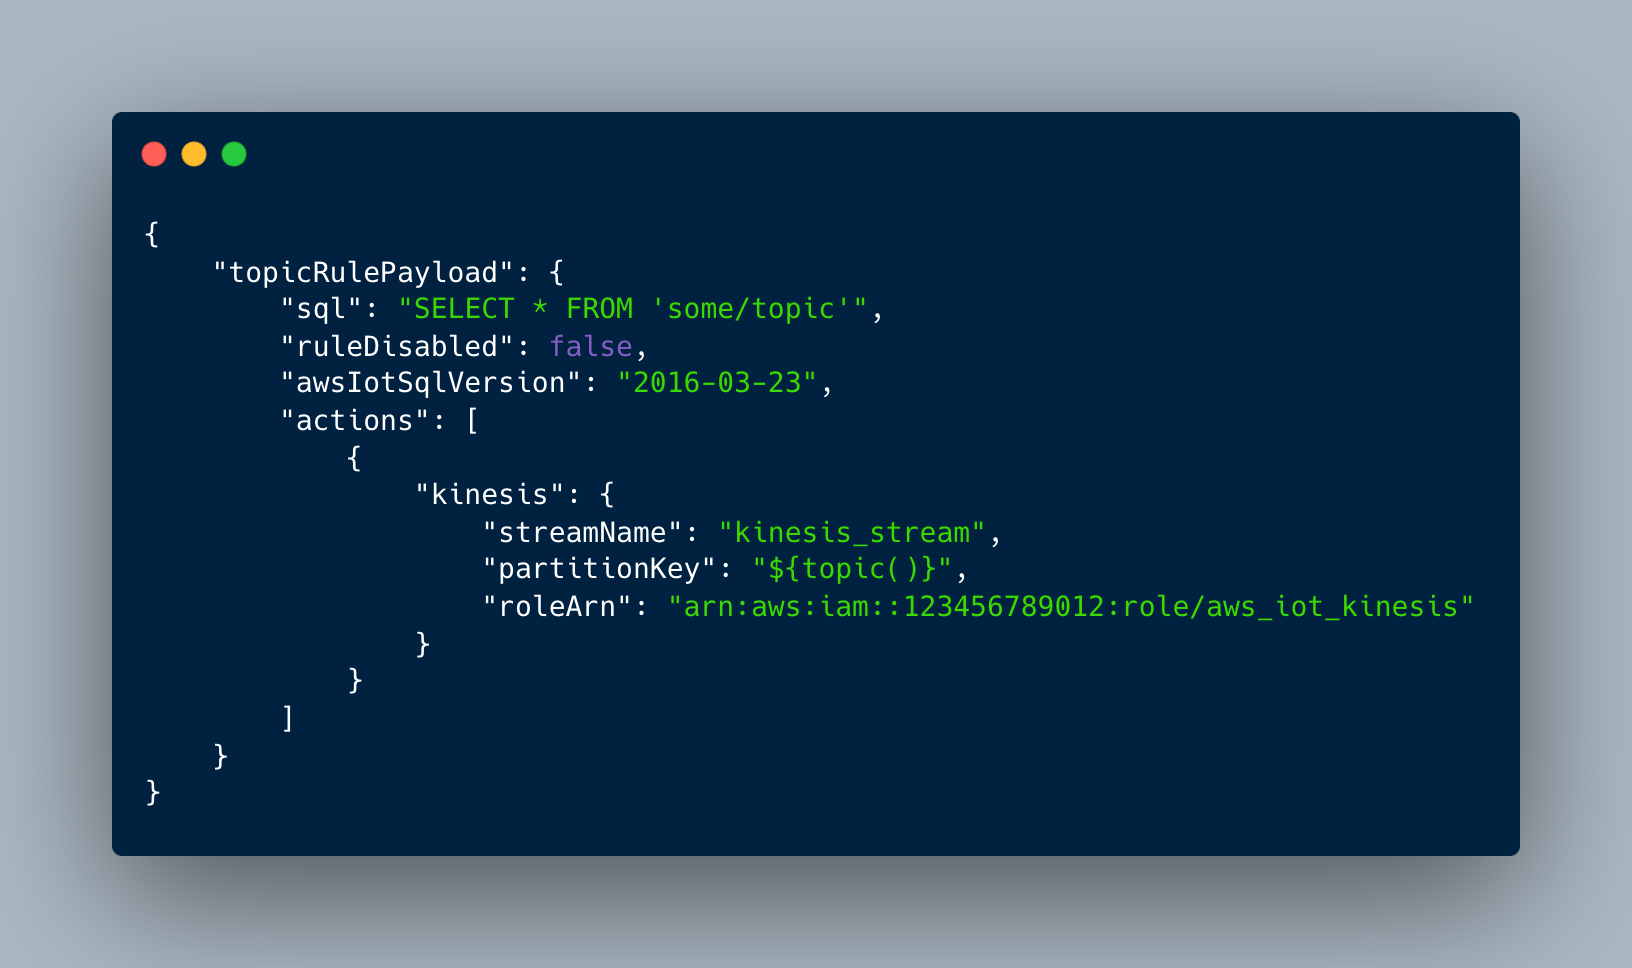

Wenn die Daten per IoT-Core entgegengenommen werden, kann das weitere Aussteuern der Daten über IoT-Rules umgesetzt werden. Diese ermöglichen es anhand von Topics und einigen Body-Informationen, unterschiedliche Folgeaktionen auszulösen. Beispielsweise kann anhand der Topic-Struktur definiert werden, welche Daten in den hot- und welche in den cold-data-Pfad fließen. Dieser Artikel beschränkt sich auf den Aufbau des cold-data-Pfades. Dazu wird in der IoT-Rule eine Aktion definiert, die ankommenden Daten direkt in Kinesis Data Firehose übergibt. Dieser Service puffert und aggregiert die Daten, bis eine gewisse Menge (etwa ein Megabyte) erreicht ist oder nach einem Zeitintervall, um diese dann an den Objektspeicher (S3) weiterzugeben. So wird eine stabile und skalierbare Datenstrecke aufgebaut, über welche die Rohdaten etwa im Json-Format entgegengenommen und abgespeichert werden können.
Datenaufbereitung und -analyse beginnt
Für die weitere Aufbereitung und Weiterverarbeitung der abgelegten Rohdaten bietet die AWS-Cloud unterschiedliche Möglichkeiten. Ein Ansatz ist eine ETL (Extract-Transform-Load)-Pipeline im AWS Serverless-Dienst Glue. Über diesen Dienst kann eine Pipeline aufbaut werden, um die Datenpunkte über ein Python-Skript zu bereinigen, erste Berechnungen durchzuführen und die Ablage in einem platzsparenden und effizient abfragbaren Format durchzuführen. Als Standard hat sich das spaltenbasierte Parquet-Format durchgesetzt. Nach dem eigentlichen Job können die Ergebnisse durch einen Crawler für die effiziente Abfrage indiziert werden. Dadurch ergeben sich zahlreiche Integrations- und Analysemöglichkeiten, wie etwa durch den Dienst Amazon Athena. Dieser ermöglicht eine SQL-basierte Abfrage der Daten und kann dadurch als Grundstein für weitere KI-gestützte Analysen genutzt werden. Auch die explorative ad-hoc-Analyse der Daten ist über ein Jupyter-Notebook möglich. Mit diesem Aufbau können Unternehmen bereits Nutzen erzielen, indem sie beispielsweise die Energieverbräuche in der Produktion erfassen und automatisiert Verbesserungspotentiale ermitteln.
Visualisierung der
Ergebnisse
Der offene Ansatz der Architektur vereinfacht die Integration in bereits bestehende Systemlandschaften. So können etwa wiederkehrende Abfragen über ein API-Gateway bereitgestellt und über http abgefragt werden. Auch eine automatische Synchronisation der Daten auf mobile Endgeräte für Servicetechniker, Instandhalter oder Außendienstler ist durch eine standardisierte Schnittstelle wie AWS AppSync umsetzbar. Auch der Datentransfer per Schnittstelle in bestehende Business Intelligence-Anwendungen wie Power BI ist möglich. Alternativ bietet AWS selbst mit seiner BI-Lösung QuickSight ein leistungsfähiges Werkzeug, um die Daten aus der Fabrik zu analysieren und die Ergebnisse in Dashboards zu visualisieren.
Bereit für die Arbeit mit Echtzeit-Daten
Sind alle Arbeiten abgeschlossen, verfügen Unternehmen über den ersten Aufbau einer kosteneffizienten Serverless-Pipeline für die Langzeitdatenspeicherung und Datenanalyse auf der AWS-Plattform. Dieser bildet die Basis für weitere Projekte. Nach einem erfolgreichen Proof of Concept lässt sich im nächsten Schritt die Verarbeitung von Live-Daten angehen. Diesem Thema ist demnächst ein eigener Artikel gewidmet.